探索数据编码:Delta Encoding
探索数据编码:Delta Encoding
访问 AWS 上存储的 Parquet 文件时,曾碰到过 不支持 Delta Encoding 导致数据读取失败。于是整理下 Delta Encoding 相关的知识,为解决连续的整型存储、Timestamp、Date 类型存储时的压缩效率问题提供参考。
数据编码指的是从一种数据格式转换成另一种数据格式的过程,用来保证传输时数据格式一致或者一定程度上压缩具备某种规律的数据格式,减少传输开销。而 Delta Encoding(翻译为增量编码),对增量数据有很好的压缩作用。
LEB128
LEB128(Little Endian Base 128)是一种变长压缩编码,区别于传统固定字节的 int 等整数类型,LEB128 可将任意大的整数存储在少量字节中。
它与可变长量(Variable-length quantity,VLQ)格式相似,主要的区别是 LEB128 是小端数,VLQ 是大端数,两者都允许对任意长的数字进行编码。
它的无符号版本是 ULEB128,解码时也必须知道编码的值是 ULEB128 还是 LEB128。
为什么需要这个编码?
如果我们从字节流中读取一个数字,假如这个数字大于 2 字节(short 类型最大值),小于 4 字节(int 类型最大值),需要花费的存储空间仍然是 4 个字节。但实际上我们读取的数字在多数情况下,实际占用并没有达到 4 个字节,比如 1024307。所以我们需要用 LEB128 压缩存储空间。
| 类型 | int | 无符号 int | short | 无符号 short |
|---|---|---|---|---|
| 最大值 | 2147483647 | 4294967295 | 32767 | 65535 |
编码过程
LEB128 编码时首先需要把一个数的转为二进制格式,然后每 7 个 bit 位划分成一组,也就是一个字节只有 7 个有效位用来存数据,这样最高位就可以用来表示当前字节后续是否还有数据,解码时可用最高位来判断:0 代表解码结束,1 代表后续还需继续解码。
假设一个数的 LEB128 编码为 0x05F4(小端数),两个字节拆分为 0xF4 和 0x05,读到 0xF4 时发现其二进制最高位是 1,代表这个 LEB128 编码的数据还没读完,读到 0x05 时,最高位是 0,就代表这个编码已经解析完,没有要读的数据了。
ULEB128(Unsigned LEB128)
我们以 1024307 这个数字举例:
大端 ---------------------> 小端 1111 1010 0001 0011 0011 -- 二进制格式 01111 1010 0001 0011 0011 -- 补0到21位 0111110 1000010 0110011 -- 每7位为1组 00111110 11000010 10110011 -- 每个字节最高位补结束标记,1继续解码,0解码完成 0x3E 0xC2 0xB3 -- 16进制,这个就是VLQ编码结果(大端数):0x3E C2 B3 -- ULEB128结果为小端数:0xB3 C2 3E1024307 的 ULEB128 编码为 0xB3C23E,从用 Int 类型的 4 字节存储压缩成 3 字节存储。
ULEB128 编解码 C 代码
编码:
void encode_uleb128(uint32_t value, uint8_t *output, int32_t* output_size) { int i = 0; while (value != 0) { output[i] = value & 0x7F; // 111 1111 value >>= 7; if (value != 0) { output[i] |= 0x80; // 1000 0000 } i++; } *output_size = i;}解码:
uint32_t decode_uleb128(const uint8_t *input) { uint32_t result = 0; int shift = 0; for (int i = 0; ; i++) { result |= (input[i] & 0x7F) << shift; if ((input[i] & 0x80) == 0) { return result; } shift += 7; }}LEB128
与 ULEB128 的区别仅在于对负数的处理:
以 -666 为例:
大端 ---------------------> 小端 10 1001 1010 -- 二进制格式 00 0010 1001 1010 -- 补0到14位 11 1101 0110 0101 -- 负数反码 11 1101 0110 0110 -- 反码+1(负数补码) 1111010 1100110 -- 每7位为1组 01111010 11100110 -- 每个字节最高位补结束标记,1继续解码,0解码完成 0x7A 0xE6 -- 16进制,VLQ编码结果(大端数):0x7A E6 -- LEB128结果为小端数:0xE6 7A上面的例子看着似乎没什么问题,但实际上对有符号 int 的 LEB128 编码是有问题的。
十六进制 -666 的有符号 int 补码表示:0xFFFF FD66,它会把 int 类型的 32 位全部占满(并不是上述例子中只占 14 位),为了凑满 7 的倍数,补到 35 位,加上每一个字节高位的结束标记,导致 LEB128 编码的结果实际上占 40 位,共 5 个字节,因此 实际上负数完全没能被压缩。
Parquet 文件格式对有符号数的处理,是使用 ZigZag 编码(也称作之字编码)代替补码运算,把有符号的正负数统一转成无符号数,再使用 ULEB128 编码,这样就能解决上述问题。
ZigZag 编码
一种有符号数编码方案,常用于 Protocal Buffers 中,原理是给正负数交替计数,可以把有符号的正负数映射成无符号数中的正数,可以解决负数压缩效率低的问题。
ZigZag 编码很简单,直接通过移位运算实现:zigzag = (n << 1) ^ (n >> k - 1),k 代表位数。比如 int 类型的 k = 32。
zigzag 函数可以把有符号正数放到无符号数的偶数位,扩展出的奇数位就能用来存负数了。使用异或运算能把负数高位的 1 置为 0。
以 32 位 int 类型为例:zigzag = (n << 1) ^ (n >> 31)
| n | hex | zigzag(hex) |
|---|---|---|
| 0 | 00 00 00 00 | 00 00 00 00 |
| -1 | FF FF FF FF | 00 00 00 01 |
| 1 | 00 00 00 01 | 00 00 00 02 |
| -2 | FF FF FF FE | 00 00 00 03 |
| 2 | 00 00 00 02 | 00 00 00 04 |
| -3 | FF FF FF FD | 00 00 00 05 |
| … |
以上表格可以看出,负数转为正数后,高位都变成 0,使用 ULEB128 就能统一对正负数的高位 0 进行压缩了。
ZigZag 编解码 C++ 代码
uint32_t zigzag_encode(const int32_t& n) { return n << 1 ^ n >> 31;} int32_t zigzag_decode(const uint32_t& n) { return static_cast<int32_t>(n >> 1 ^ -(n & 1)); // -(n & 1) = ~(n & 1) + 1)}Delta Encoding(增量编码)
在 Parquet 中,一般用于编码 int、timestamp、date 等可以存在增量的类型,这些类型在 Parquet 格式里对应的物理类型一般是 INT32 或 INT64。
格式
将一组数据编码成一个 Header 和多个 Block 的变长数组:
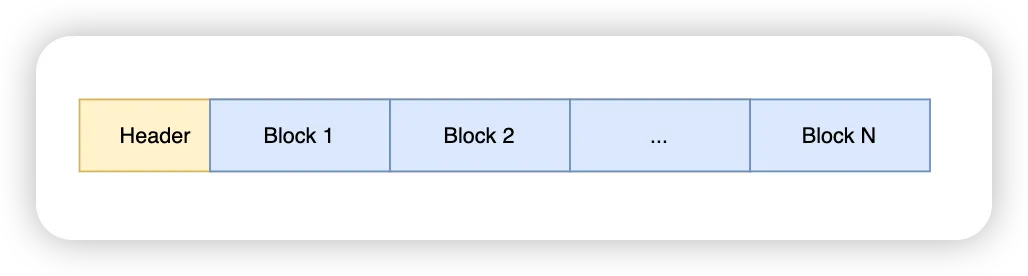
其中,每个 Block 又是由多个 mini block 组成。
Header
一个 delta 编码的 header 需要记录每个 block 大小、每个 block 由多少个 miniblock 组成、存多少个值、第一个数的值。
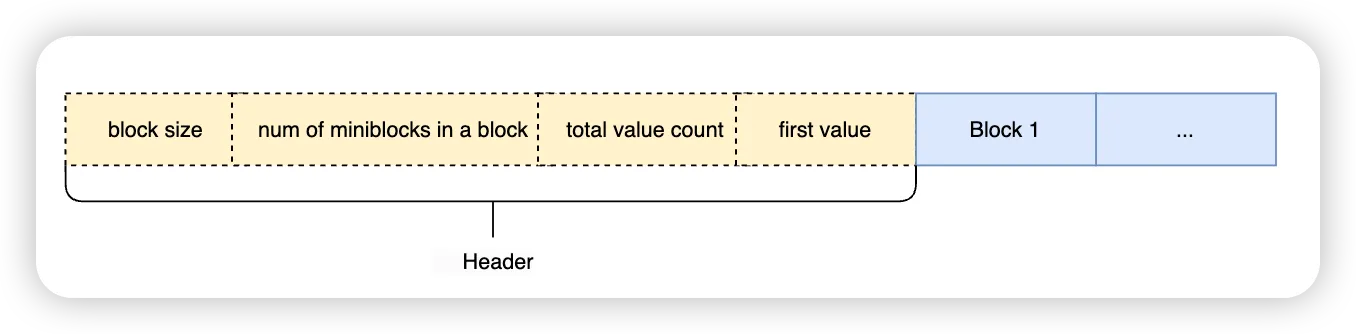
- 只有 the first value(有符号数)使用 ZigZag + ULEB128 编码,其他三个属性(无符号数)使用 ULEB128 编码
- block size 是 128 的倍数,一个 block 不一定存满,因此读取完每个 block 需要跳过末尾的 padding,保证 block 对齐。
- mini block 的大小(block size / num of miniblocks per block)必须是 32 的倍数,假设 block size = 128,num of miniblocks = 4,那么每个 miniblocks 大小就是 128 / 4 = 32 bit。
Block
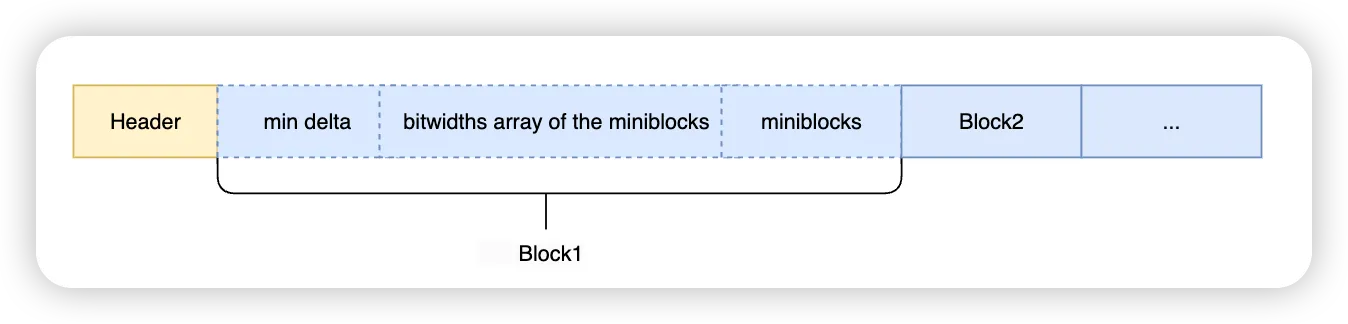
- min delta(有符号数)使用 ZigZag + ULEB128 编码
- miniblock 用来存一组数据的增量,每个 mini block 的位宽用 1 字节存储,获取位宽时不足一字节需要对齐。
- 每个 miniblock 都是根据它存放在 bitwidths 的位宽构造成的位序列(bit packed),这里的 bitwidths 数组可以理解为将 miniblock 进一步按不同的位宽去划分每一个增量需要的位数。
接着 Header 中计算 miniblock 大小的例子:
- block size = 128,4 个 miniblock,每个 miniblock 占 32 位
- bitwidths 数组中存 4 个位宽:2、4、8、2
- 每个 miniblock 存的增量值的个数:16(32/2)、8(32/4)、4(32/8)、16
- 在 miniblock 1 中,位宽为 2,相当于存 16 个 short 的增量值
- 在 miniblock 2 中,位宽为 4,相当于存 8 个 int 型的增量值
- miniblocks 存放每个完成打包的 miniblock。
示例
官方的例子假设了 block size = 8(实际使用一定是 128 的倍数)用于演示:
数据:7, 5, 3, 1, 2, 3, 4, 5,the deltas would be
-2, -2, -2, 1, 1, 1, 1
The minimum is -2,so the relative deltas are:
0, 0, 0, 3, 3, 3, 3
The encoded data is
header: 8 (block size), 1 (miniblock count), 8 (value count), 7 (first value)
block: -2 (minimum delta), 2 (bitwidth), 00000011111111b (0,0,0,3,3,3,3 packed on 2 bits)
在展示的 block 中,3 的二进制表示 11,位宽为 2,组成 mini block:00 00 00 11 11 11 11,每 2 个比特位用于存储 delta 数值,压缩了整型的存储空间。
官方例子里,只有一个位宽为 2 的 miniblock,我们可以假设,后续增量在 4-7 之间(100-111),位宽为 3,那么第二个位宽为 3 的 miniblock 里,可以存 4、5、6、7 这四个增量的值。
在一个 block 中,根据 first value, min delta, delta(根据位宽解码 mini block 得到)就能够确定存储的数据:
7 (first value)7 +(-2) + (0) = 55 +(-2) + (0) = 33 +(-2) + (0) = 11 +(-2) + (3) = 22 +(-2) + (3) = 33 +(-2) + (3) = 44 +(-2) + (3) = 5该例子中,数值都比较小,对于 timestamp 这类大数值类型来说,只存增量让它的压缩效率非常高。
与 RLE/bit packing 编码相比,delta encoding 每个 mini block 的位宽可以是不同的,而 RLE 在整个 Page 使用统一的位宽。
另外,如果一个 block 里头的 delta 增量都是相同值,位宽就是 0,只作为标头:
1, 2, 3, 4, 5
After step 1),we compute the deltas as:
1, 1, 1, 1
The minimum delta is 1 and after step 2,the relative deltas become:
0, 0, 0, 0
The final encoded data is:
header: 8 (block size), 1 (miniblock count), 5 (value count), 1 (first value)
block: 1 (minimum delta), 0 (bitwidth), (no data needed for bitwidth 0)
编码步骤
- 根据数据量,选择合适的 block size 和每个 block 的 miniblock 数目,ULEB128 编码后写入 Header
- 总的元素值的个数 ULEB128 编码后写入 Header
- 第一个值,ZigZag + ULEB128 编码后写入 Header
- 计算各元素间的差值,作为增量 delta,找到最小增量 min delta,ZigZag + ULEB128 编码后写入 Block。
- 使用 min delta 作为参照,计算 block 中所有 delta 增量减去 min delta 的值,得到 miniblock 的每一个 delta。
- 根据 block size / miniblock 数目,以及 delta 的大小,划分 miniblock,计算位宽数组 bitwidths,直接写入 Block。
- 每个 minblock 的 delta 根据位宽打包,组成 minblocks,直接写入 Block
- 写满当前 Block,继续写下一个 Block,重新计算 delta。
特例就是 delta 增量都是相同值时,block 里只有 min delta,除了 header 和 min delta,不会有额外的存储空间,这对连续的 timestamp 类型来说,大大提高了压缩效率。
参考
- Parquet Encoding https://parquet.apache.org/docs/file-format/data-pages/encodings/
© 本文著作权归作者所有,转载请注明出处。